302.AI 基准实验室 | AI视力考验:各AI模型的视觉理解能力如何?

近日,行业内有不少新模型涌现出大众的面前,我们会发现,有的模型会在其官方宣传中提到“多模态”一词,比如大家熟知的GPT-4o、Gemini 1.5 Pro等,在发布时都被定义为“原生多模态”,这些多模态LLM在相关的介绍中,都用到了“视觉能力”、“视觉理解”这样的表述。

简单的理解,就是这些模型能够“看得见,并看得懂”,仿佛人的眼睛。为此,很多人产生了疑问,AI模型真的拥有类人的视觉能力吗?

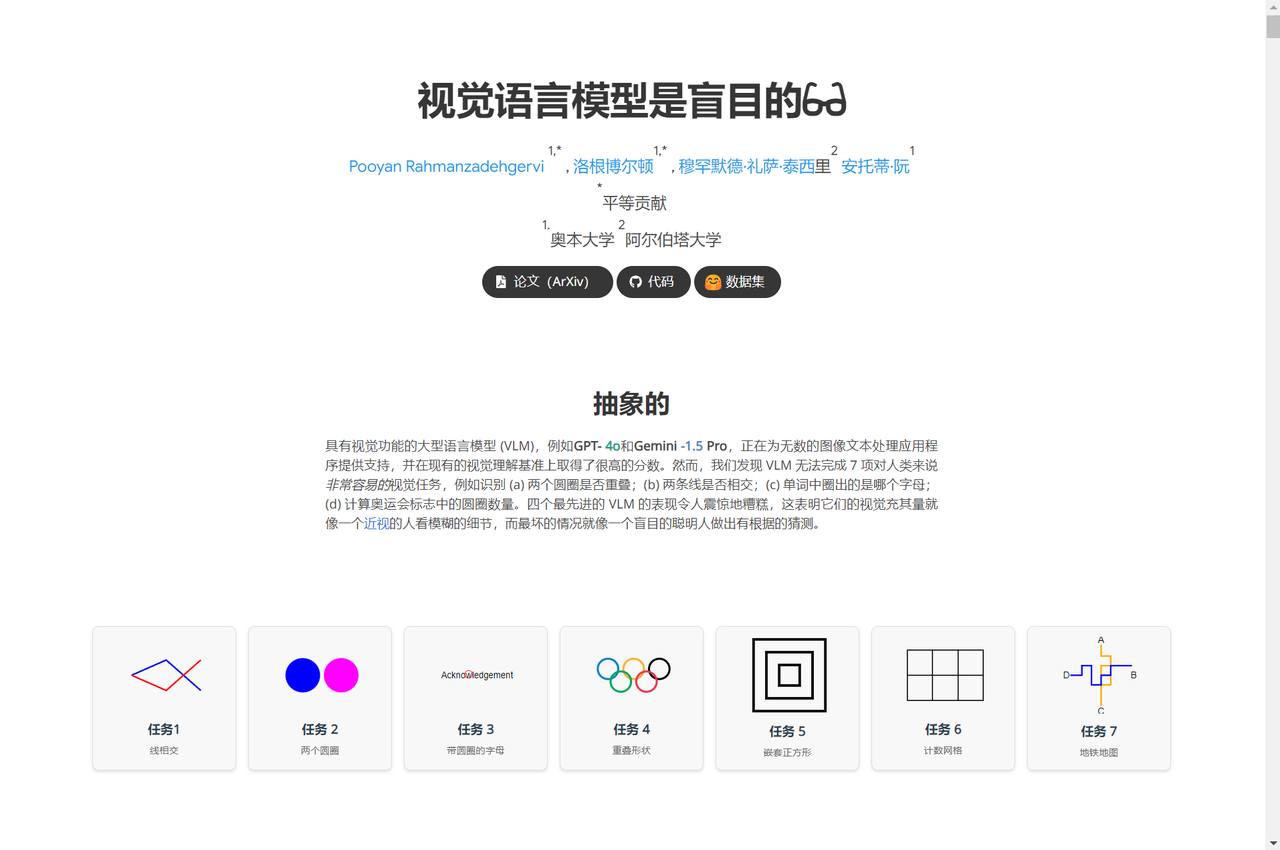
为了验证这一问题的答案,就在近日,奥本大学和阿尔伯塔大学的研究人员在一系列非常简单的视觉任务上测试了4个当今最先进的多模态模型,这些任务对人类来说极其简单,比如两个形状是否重叠、图片中有多少个五边形,或者单词中的哪个字母被圈了起来。
302.AI 基准实验室 | AI视力考验:各AI模型的视觉理解能力如何?

小编也借助这一研究中的视觉题目,给AI模型做了视力测试,看看结果是否和上述研究中的一样。

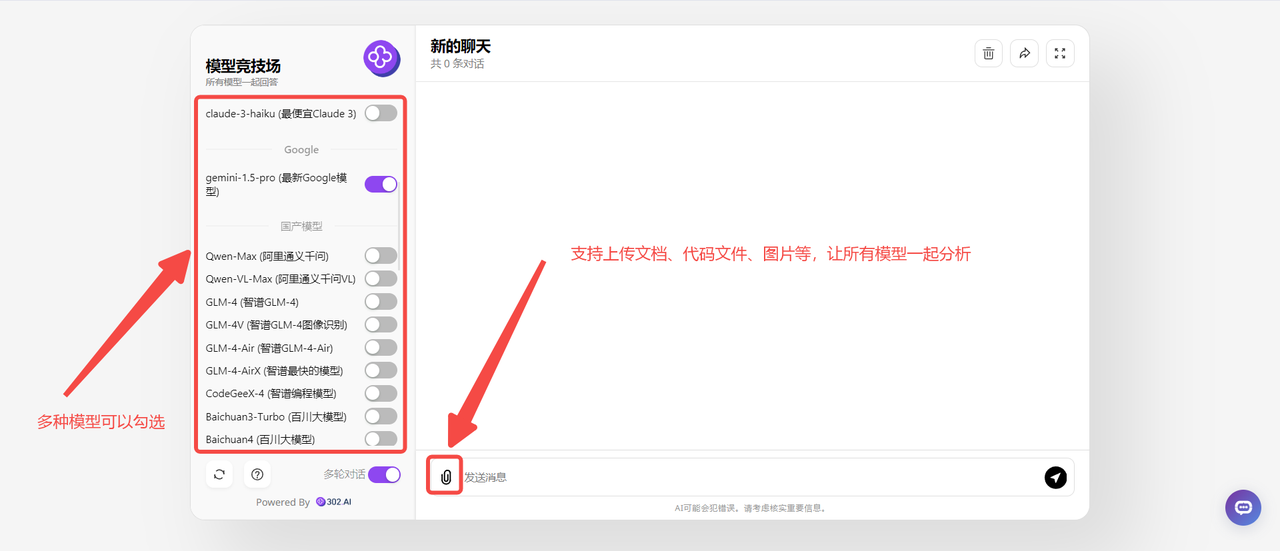
首先找到302.AI的模型竞技场,302.AI的模型竞技场提供了国内外众多最新、最全面的AI模型,且支持上传文档、图片、代码文件等,让所有模型一起分析。

用户可以选择不同的模型,并同时提出问题以获得回答,这种方式极大地方便了我们比较不同模型答案。最重要的是,302.AI提供的是按需付费的使用方式,无论是日常工作、生活需要使用模型机器人还是还是进行不同模型的测试研究,都能有效节省成本,便于使用。
302.AI 基准实验室 | AI视力考验:各AI模型的视觉理解能力如何?

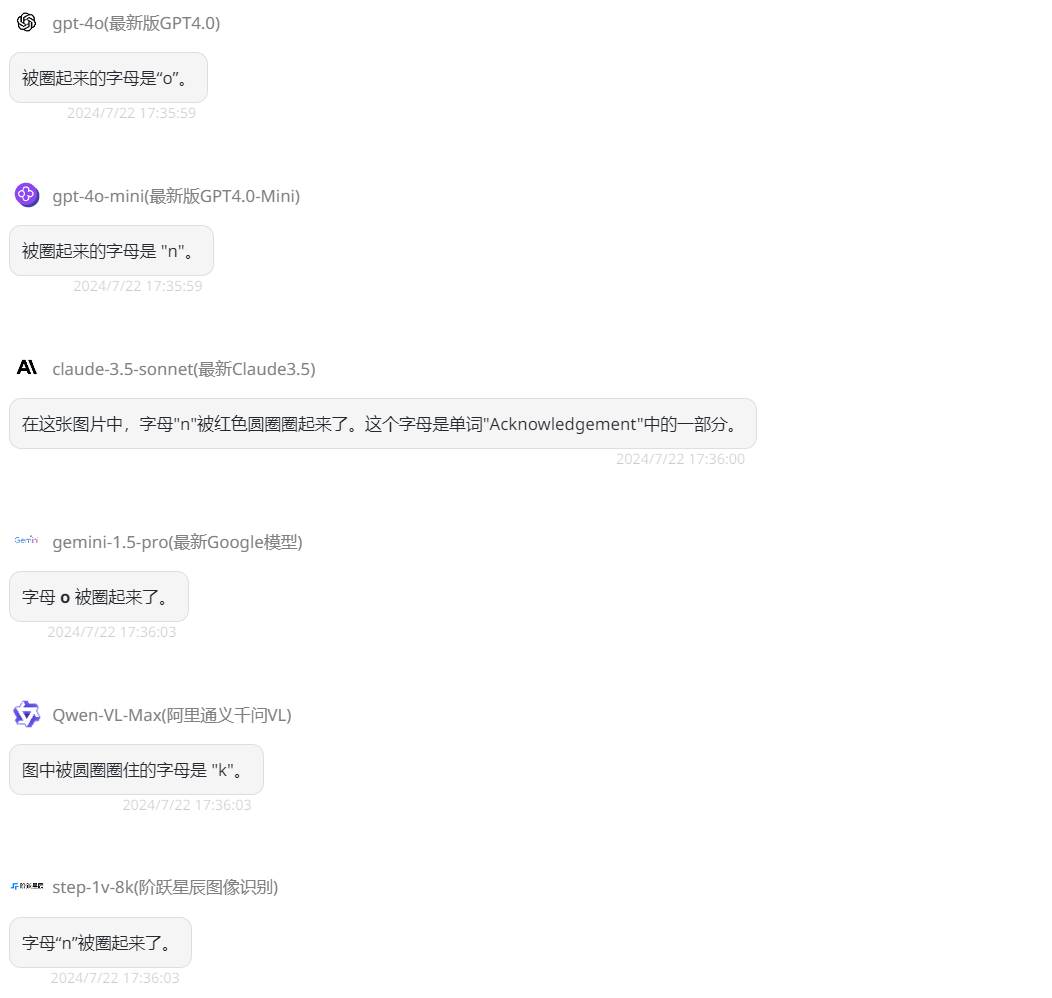
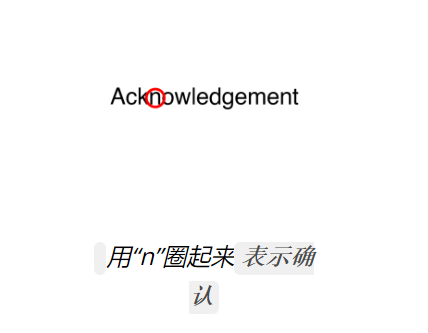
小编勾选的,GPT-4o、GPT-4o mini、Gemini 1.5 Pro、Claude-3.5-Sonnet、Qwen-VL-Max、Step-1v-8k六种模型。首先提问简单的第一道题:“哪个字母被圈起来了?”
302.AI 基准实验室 | AI视力考验:各AI模型的视觉理解能力如何?

看下各模型的回答:

302.AI 基准实验室 | AI视力考验:各AI模型的视觉理解能力如何?

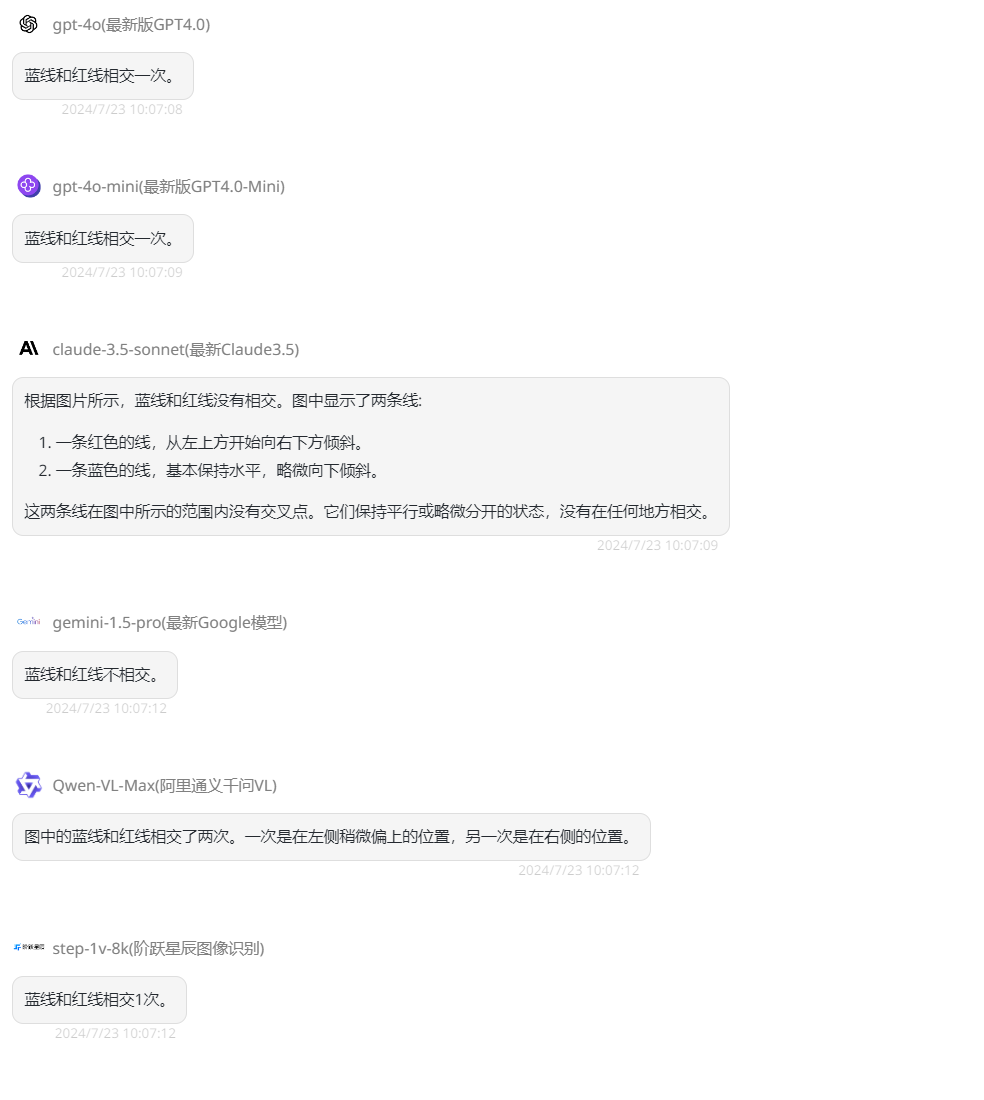
第一题就出现了三对三错的情况,GPT-4o mini、Claude-3.5-Sonnet、Step-1v-8k回答正确,而GPT-4o、Gemini 1.5 Pro、Qwen-VL-Max回答错误,那接下来增加难度,提问第二题:“蓝线和红线相交多少次?”
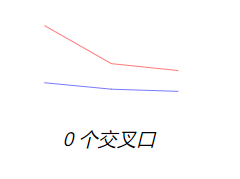
302.AI 基准实验室 | AI视力考验:各AI模型的视觉理解能力如何?

看下各模型答案:

302.AI 基准实验室 | AI视力考验:各AI模型的视觉理解能力如何?

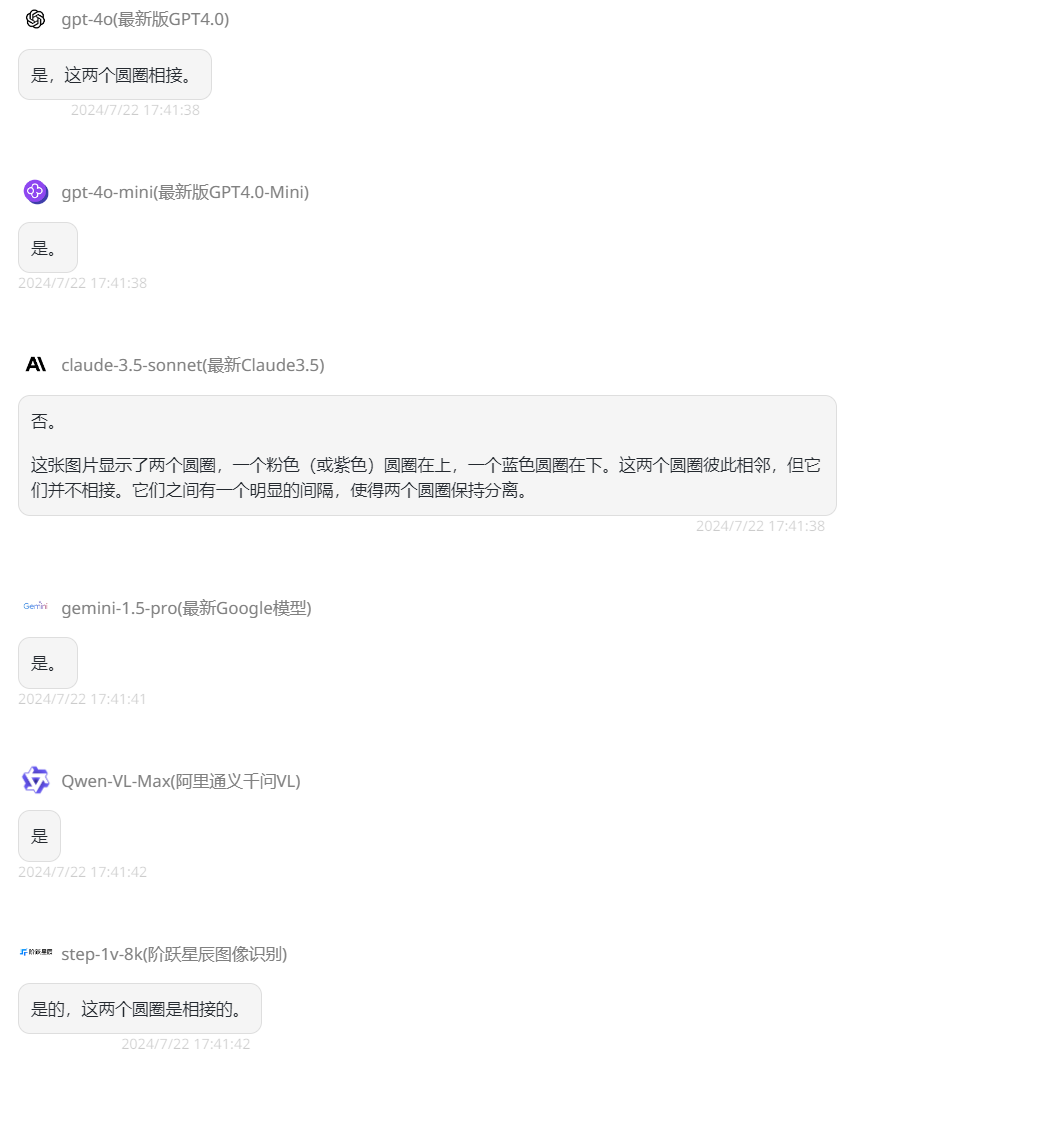
第二题只有Gemini 1.5 Pro、Claude-3.5-Sonnet答对了。接下来换第三题,提问:“这两个圆圈相接吗?回答是/否。”
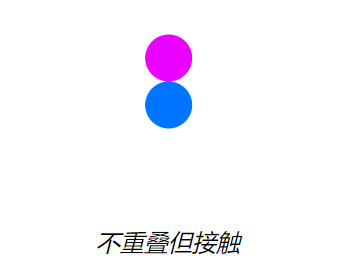
302.AI 基准实验室 | AI视力考验:各AI模型的视觉理解能力如何?

看下答案:

302.AI 基准实验室 | AI视力考验:各AI模型的视觉理解能力如何?

只有Claude-3.5-Sonnet答错了,其余都回答正确。最后一题:“图片中有多少个【形状】?请仅用数字格式回答。”,正确答案应该是8个,看下各模型回答:
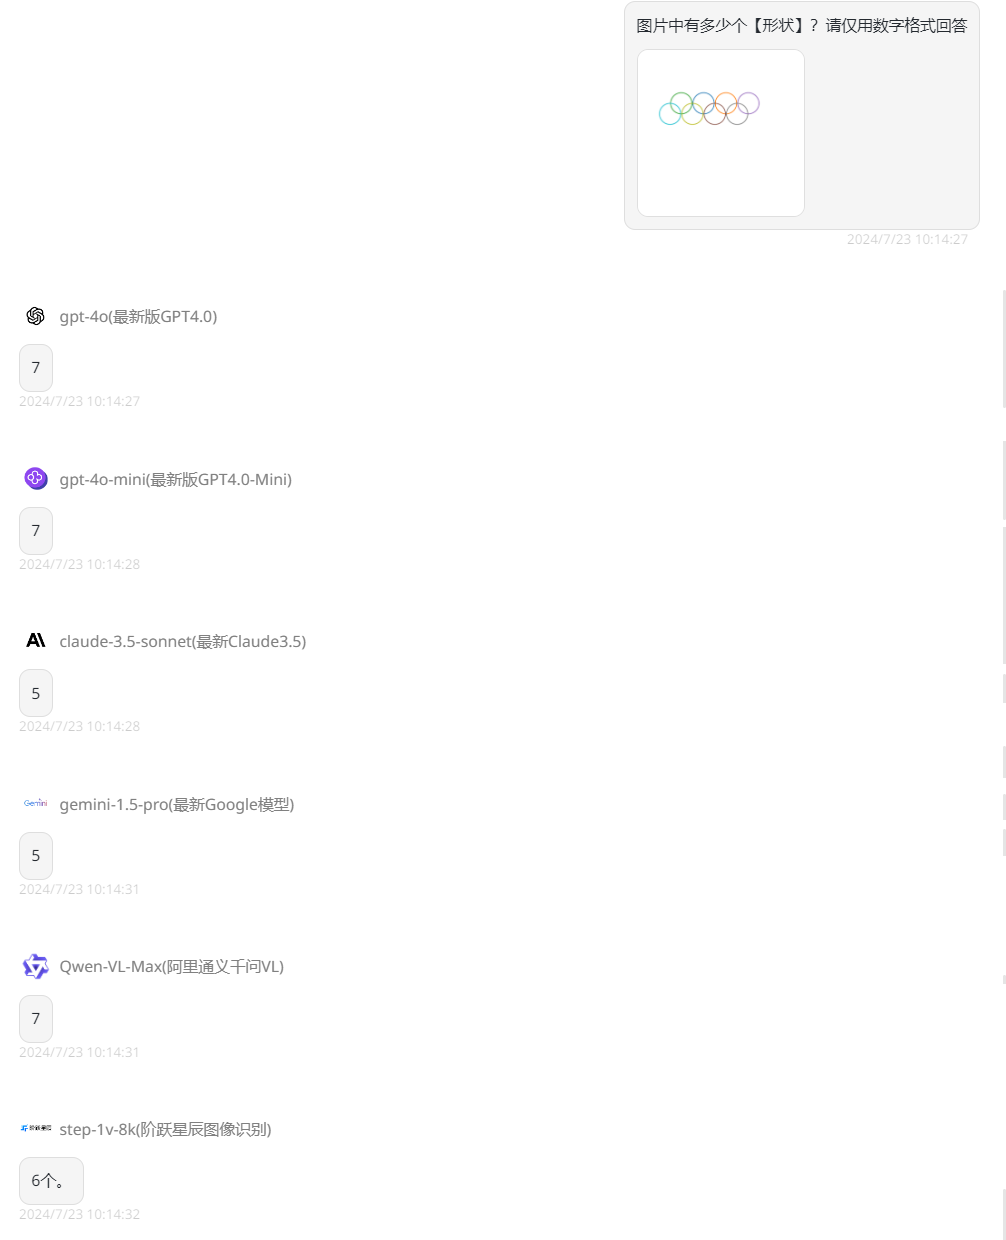
302.AI 基准实验室 | AI视力考验:各AI模型的视觉理解能力如何?

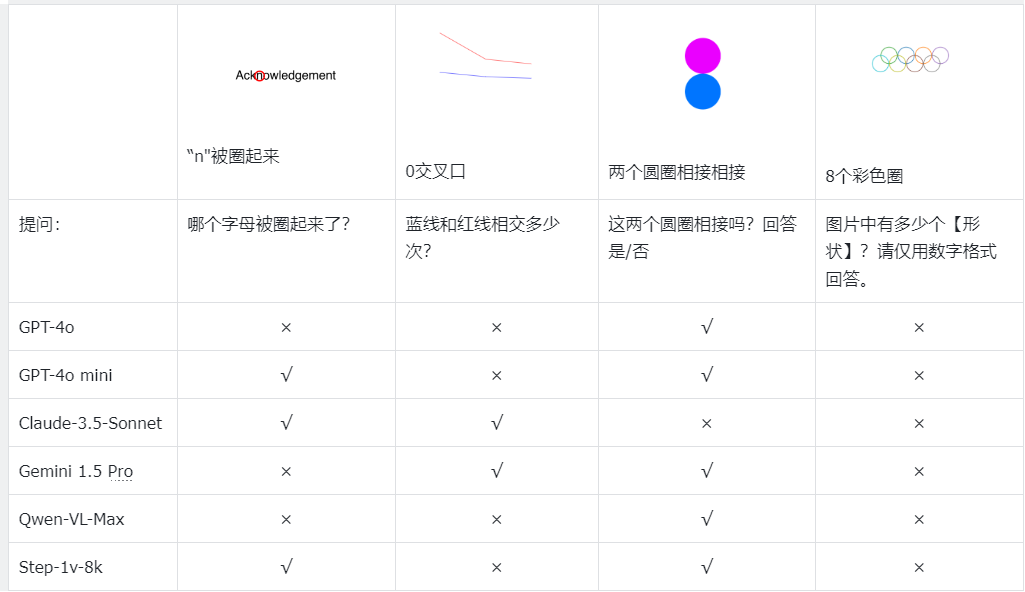
最后一题居然没有模型答对,下面对四题答对情况整理一下:

302.AI 基准实验室 | AI视力考验:各AI模型的视觉理解能力如何?

通过简单的实践可以看到,这些模型的视觉对于简单的图像能基本回答正确,而稍微复杂点的图形问题就明显出现“蒙圈”状态。

而最后想说,研究的意义并不是想要否定这些模型的“视觉能力”,我们需要明确AI模型的“视力”并不可能等于传统意义上人类的视觉能力。模型处理视觉信息的方式是通过分析和识别图像数据中的模式和特征。随着深度学习技术的进步,AI在图像识别、物体检测和场景理解等方面已经取得了显著的成果。

参考文章:

https://mp.weixin.qq.com/s/1YFtLExzgwoy5GvWZX_2TQ

https://vlmsareblind.github.io/#task3


👉立即注册免费试用302.AI,开启你的AI之旅!👈

为什么选择302.AI?

● 灵活付费:无需月费,按需付费,成本可控
● 丰富功能:从文字、图片到视频,应有尽有,满足多种场景需求
● 开源生态:支持开发者深度定制,打造专属AI应用
● 易用性:界面友好,操作简单,快速上手
302.AI 新品发布 | 图像创意站:GPT-Image-1玩法全解析,轻松生成惊艳作品
All Rights Reserved by 302.AI
赞 (0)
302.AI
上一篇 2024 年 7 月 23 日 下午5:45
下一篇 2024 年 7 月 25 日 下午5:34

相关推荐

  • Kimi K3.1 Pro 实测:3D与前端视觉惊艳,1/5 价格拿下旗舰级编程丨302.AI

    📖 文章导读:月之暗面发布 Kimi K3.1 Pro,历经 99 天 RL 重炼,AA 智力指数冲至全球第四,预定最强开源模型,API 价格再砍三分之一。实测发现,K3.1 Pro 在视觉审美上优势突出,力压 GPT-6 Astra,编程基准也实现超越。本文带你速览升级亮点与真实生产力边界,看国产旗舰如何与海外顶流正面掰手腕。 从 K3 破局到 K3.1 …

    4天前 • 基准实验室
    7950
  • MiniMax M3.1 Flash实测:对比 DeepSeek 1017,有何亮点丨302.AI

    📖 文章导读:匿名 25 天、默默消化 200T token 的 Space Bunny 终于揭面——正是 MiniMax M3.1 Flash。与仅隔 2 天发布的 DeepSeek-V4.1-Flash-1017 正面对决,跑分互有胜负,但二者并非简单的“双强并立”。实测验证,M3.1 Flash 不是平替,而是另一把工具——适合谁、怎么选,一文讲清。 …

    2026 年 10 月 23 日 • 基准实验室
    1.2K0
  • DeepSeek V4.1-Flash-1017 实测:Flash 档跑进旗舰分数段,能力上限再被刷新丨302.AI

    📖 文章导读:DeepSeek-V4.1-Flash-1017 低调上线,基准成绩杀进旗舰分数段。DeepSWE 通过率 77.0,压过 Claude Opus 5 和 GPT-5.6-Sol;单任务成本不到 8 毛,只有对手的百分之一。实测视觉和创意已经够打,工程完成度仍有代差。这不是一次常规升级,是 Flash 这个档位的重新定价。 详细了解DeepSe…

    2026 年 10 月 21 日 • 基准实验室
    1.4K0
  • Gemini 4 Argon 实测:硬实力回到第一梯队,但还不是全能选手 | 302.AI

    📖 文章导读:Google 背水一战搬出 Gemini 4 Argon,硬实力重返第一梯队。长输出与知识工作上表现惊艳,以绝对的成本优势紧咬 GPT-6 Astra。实测显示,Argon 在金融、法律等专业领域结构性领先,编程达旗舰水准,但工程完成度与 Agent 能力仍是明显短板。这场翻身仗,Google 赢回了与顶级模型掰手腕的资格,也暴露了从“聪明”到…

    2026 年 10 月 16 日 • 基准实验室
    1.7K0

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注

评论列表(1条)

  • Percy Gonchoff 2025 年 7 月 28 日 下午6:59

    I’m not that much of a internet reader to be honest but your blogs really nice, keep it up! I’ll go ahead and bookmark your site to come back later on. Cheers